MTBF e MTTR: Entenda a confiabilidade e a disponibilidade do seu software
Imagine a seguinte cena: você é o desenvolvedor ou o DevOps de plantão e, de repente, o monitoramento começa a apitar. O sistema caiu. Novamente. O time de suporte está desesperado, os clientes estão reclamando nas redes sociais e a gerência quer saber “o que aconteceu”. Após horas de tensão, o serviço volta ao normal. Mas a pergunta que fica no ar é: quão confiável é o nosso software? E quão rápidos fomos para resolver o problema?
No mundo da tecnologia, falhas são inevitáveis. Nenhum sistema é 100% à prova de erros. No entanto, a diferença entre um time amador e uma equipe de engenharia de elite está na capacidade de medir, entender e melhorar a frequência e a duração dessas falhas. É aqui que entram duas siglas fundamentais: MTBF e MTTR. Elas são as bússolas que guiam os times de QA, Desenvolvimento e Operações (DevOps) para entender a saúde real de um produto digital.
Neste artigo, vamos desmistificar esses conceitos. Vamos sair da teoria acadêmica e mostrar como o MTBF e o MTTR impactam o seu dia a dia, como calculá-los de forma simples e, o mais importante, como usá-los para parar de apenas “apagar incêndios” e começar a construir sistemas resilientes. Se você quer elevar o nível da sua discussão técnica e entender como as grandes empresas garantem que seus serviços estejam sempre disponíveis, este guia é o seu ponto de partida.
O que é MTBF? Medindo a Confiabilidade
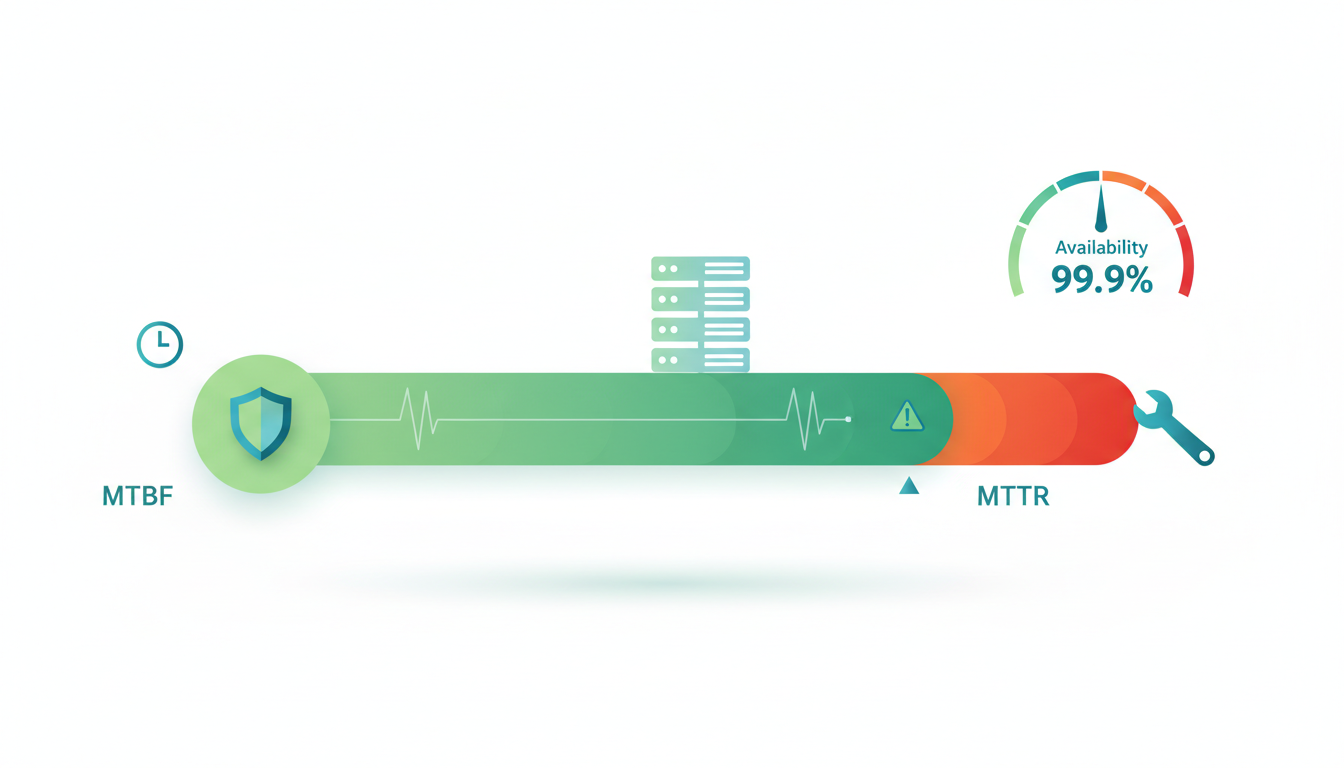
O MTBF (Mean Time Between Failures, ou Tempo Médio Entre Falhas) é a métrica que nos diz quanto tempo o sistema consegue rodar perfeitamente antes de apresentar um problema. Em termos simples: é o tempo que o software passa “em paz”. Se o seu MTBF é alto, significa que o seu sistema é confiável. Ele não quebra com frequência e os usuários podem confiar que ele estará lá quando precisarem.
Para um QA ou um Desenvolvedor, um MTBF baixo é um sinal de alerta vermelho. Ele indica que o código pode estar instável, que os testes de regressão não estão sendo eficazes ou que a infraestrutura está subdimensionada. Quando o MTBF cai, o time entra em um ciclo de exaustão, pois nunca há tempo para criar novas funcionalidades; todo o esforço é gasto corrigindo erros que surgem a cada poucos dias ou horas.
Aumentar o MTBF exige foco em prevenção. Isso envolve melhores práticas de codificação, revisões de código mais rigorosas, testes automatizados abrangentes e uma arquitetura que suporte picos de carga. O MTBF é o indicador de que o seu trabalho de “construção” foi bem feito e que o software é robusto o suficiente para enfrentar o mundo real sem desmoronar.
O que é MTTR? Medindo a Agilidade na Recuperação
Se o MTBF foca em evitar que o problema aconteça, o MTTR (Mean Time To Repair, ou Tempo Médio para Reparo) foca no que acontece depois que algo quebra. Ele mede o tempo total que o time leva para detectar, diagnosticar e resolver um incidente, devolvendo o sistema ao estado de funcionamento normal. Em termos práticos: é o cronômetro que começa a correr no momento em que o alerta apita e só para quando o usuário consegue acessar o serviço novamente.
Para um profissional de DevOps ou SRE, o MTTR é a métrica de ouro da resiliência. Um MTTR baixo indica um time ágil, com bons processos de observabilidade (monitoramento) e automação de recuperação. Se o seu MTTR é alto, significa que o time demora muito para descobrir a causa raiz ou que o processo de correção é manual, lento e burocrático. Em um cenário de crise, cada minuto de MTTR alto representa prejuízo financeiro e perda de reputação para a empresa.
Melhorar o MTTR exige foco em resposta a incidentes. Isso envolve ter alertas inteligentes (que não geram ruído), playbooks (manuais de ação) bem definidos, ferramentas de rollback rápido (voltar para a versão anterior do código com um clique) e uma cultura de colaboração onde todos sabem exatamente o que fazer quando o sistema cai. O MTTR aceita que falhas vão ocorrer, mas garante que elas sejam apenas “soluços” rápidos, e não paralisias prolongadas.
A Matemática Simples por trás das Siglas
Não se deixe intimidar pelas siglas; o cálculo dessas métricas é puramente aritmético e pode ser feito com dados simples do seu monitoramento. Vamos usar um exemplo prático: imagine que em um período de 24 horas (1.440 minutos), o seu sistema apresentou 3 falhas. O tempo total que o sistema ficou fora do ar (Downtime) somando as três quedas foi de 60 minutos.
Calculando o MTBF (Confiabilidade):
A fórmula é:
No nosso exemplo:
Resultado: O seu sistema consegue rodar, em média, 460 minutos (quase 8 horas) entre uma queda e outra.
Calculando o MTTR (Recuperação):
A fórmula é:
No nosso exemplo:
Resultado: O seu time leva, em média, 20 minutos para colocar o sistema de volta no ar após uma falha.
Esses números isolados dizem pouco, mas quando acompanhados ao longo de semanas ou meses, eles revelam a tendência da sua engenharia. Se o MTBF está diminuindo e o MTTR está aumentando, o seu time está perdendo o controle sobre a estabilidade do produto.
Disponibilidade (Uptime): Onde as métricas se encontram
A Disponibilidade é o indicador que o seu cliente e o seu chefe realmente acompanham. É o famoso “o site está no ar?”. Ela é expressa em porcentagem (como os desejados 99,9% ou 99,99%) e é o resultado direto da relação entre o MTBF e o MTTR. Matematicamente, a disponibilidade é calculada pela fórmula:
Essa fórmula revela uma verdade cruel da engenharia de software: para ter alta disponibilidade, você tem apenas dois caminhos. Ou você faz o sistema parar de quebrar (aumenta o MTBF), ou você garante que, quando ele quebrar, ele volte à vida em segundos (diminui o MTTR).
Se o seu sistema tem um MTBF de 100 horas e um MTTR de 1 hora, sua disponibilidade é de aproximadamente 99%. Parece bom? Em um mês, isso significa mais de 7 horas fora do ar. Para um e-commerce ou um banco, isso é inaceitável. Entender essa conexão permite que o time de DevOps e QA pare de olhar para incidentes isolados e comece a olhar para a saúde sistêmica do produto.
MTBF vs. MTTR: Onde focar seus esforços?
Este é o grande dilema de quem está começando na área. Se os recursos e o tempo do time são limitados, onde investir primeiro? A resposta depende da maturidade do seu software e do impacto da falha no seu negócio.
- Foque no MTBF (Prevenção) se: O custo de uma queda é catastrófico. Se você trabalha com sistemas de saúde, aviação ou transações financeiras críticas, o sistema simplesmente não pode cair. Aqui, o investimento deve ser em testes exaustivos, redundância de hardware e revisões de arquitetura para evitar o erro a todo custo.
- Foque no MTTR (Recuperação) se: Você trabalha em um ambiente de inovação rápida (SaaS, redes sociais, apps de entrega). Nestes cenários, falhas vão acontecer porque o código muda todo dia. O segredo é a resiliência. É melhor ter um sistema que cai uma vez por semana e volta em 30 segundos (MTTR baixo) do que um que cai uma vez por mês e fica 5 horas fora do ar (MTTR alto).
Para um time iniciante, a tendência moderna (especialmente em SRE) é priorizar a redução do MTTR. Por quê? Porque é mais barato e eficiente automatizar a recuperação e o monitoramento do que tentar prever todos os erros possíveis em um sistema complexo. Um time que recupera rápido tem mais liberdade para inovar e correr riscos calculados.
Como melhorar essas métricas na prática?
Agora que você entende os conceitos, como aplicá-los no seu dia a dia como QA, Dev ou DevOps? Melhorar o MTBF e o MTTR não é apenas uma questão de “trabalhar mais”, mas de trabalhar com as ferramentas e processos certos:
Para aumentar o MTBF (Prevenção):
- Testes Automatizados de Regressão: Garanta que cada nova funcionalidade não quebre o que já estava funcionando. Um conjunto sólido de testes unitários e de integração é o melhor seguro para o seu MTBF.
- Code Review Rigoroso: Duas cabeças pensam melhor que uma. Revisões de código focadas em segurança e performance evitam que erros bobos cheguem à produção.
- Análise de Causa Raiz (Post-mortems): Quando algo quebrar, não apenas conserte. Investigue o “porquê”. Se você resolve a causa raiz, aquela falha específica nunca mais diminuirá o seu MTBF.
Para diminuir o MTTR (Recuperação):
- Observabilidade e Alertas: Você não pode consertar o que não vê. Use ferramentas de monitoramento (como Prometheus, Grafana ou Datadog) para ser avisado de um erro antes mesmo que o primeiro cliente perceba.
- Automação de Deploy e Rollback: Se um novo código causou o erro, você deve ser capaz de “desfazer” a atualização em segundos. O rollback automático é o maior inimigo do MTTR alto.
- Playbooks de Incidente: Documente os passos para resolver os problemas mais comuns. Em um momento de crise, seguir um roteiro pré-definido reduz o pânico e acelera o diagnóstico.
Conclusão
MTBF e MTTR não são apenas siglas para gestores preencherem planilhas; elas são o pulso da sua engenharia de software. Para quem está começando em QA, Desenvolvimento ou DevOps, dominar essas métricas significa sair da reatividade e passar para a proatividade. Entender que a confiabilidade (MTBF) e a agilidade na recuperação (MTTR) são as duas faces da mesma moeda — a disponibilidade — é o que define um profissional de alta performance.
Ao monitorar esses indicadores, você para de discutir opiniões (“eu acho que o sistema está instável”) e passa a discutir fatos (“nosso MTBF caiu 20% este mês, precisamos focar em dívida técnica”). O objetivo final não é a perfeição, mas a previsibilidade. Um sistema que falha pouco e se recupera rápido é um sistema que gera confiança no cliente e paz de espírito para o time técnico. Comece a medir hoje, entenda seus gargalos e transforme o caos dos incidentes em uma jornada de melhoria contínua.
Perguntas Frequentes (FAQ)
1. O MTBF se aplica a softwares que nunca param (SaaS)?
Sim. Embora o termo tenha origem no hardware (onde as peças queimam), no software o MTBF mede o tempo entre erros críticos que impedem o uso do sistema, como um crash do servidor ou uma falha no banco de dados.
2. Qual é um “bom” MTTR para um time iniciante?
Depende do negócio, mas um objetivo saudável para a maioria dos times de SaaS é um MTTR abaixo de 60 minutos. Times de elite (como Netflix ou Amazon) trabalham com MTTR na casa dos segundos ou poucos minutos através de automação pesada.
3. Posso ter um MTBF alto e uma disponibilidade baixa?
Sim, se o seu MTTR for absurdamente alto. Se o seu sistema cai apenas uma vez por ano (MTBF alto), mas fica fora do ar por uma semana inteira (MTTR altíssimo), sua disponibilidade anual será ruim. Por isso, as duas métricas devem ser analisadas juntas.
4. Quem é o responsável por essas métricas no time?
A responsabilidade é compartilhada. O Dev e o QA influenciam mais o MTBF (qualidade do código), enquanto o DevOps/SRE influencia mais o MTTR (infraestrutura e resposta a incidentes). O sucesso depende da colaboração entre todos.
5. Como explicar MTBF e MTTR para um cliente leigo?
Diga que o MTBF é a “resistência” do carro (quantos quilômetros ele roda sem ir à oficina) e o MTTR é a “velocidade do mecânico” (quanto tempo o carro fica parado no conserto). O cliente quer um carro que quebre pouco e, se quebrar, seja consertado rápido para ele seguir viagem.